Nicht nur „läuft es?“.
Sondern „wie geht es ihm?“
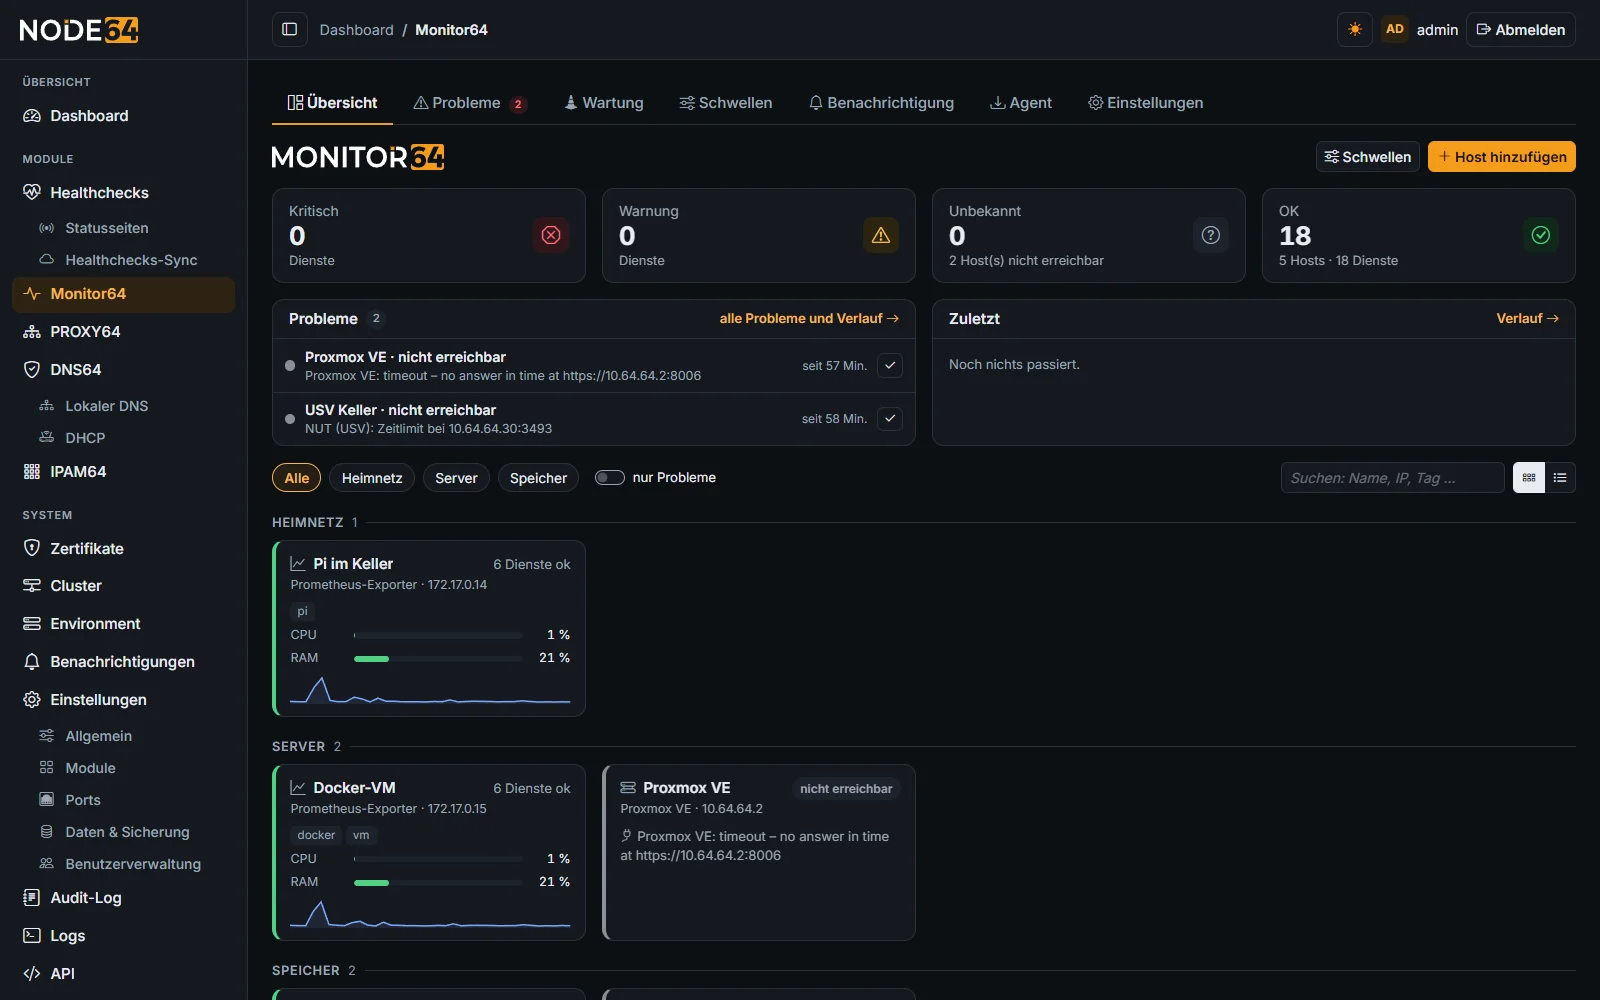
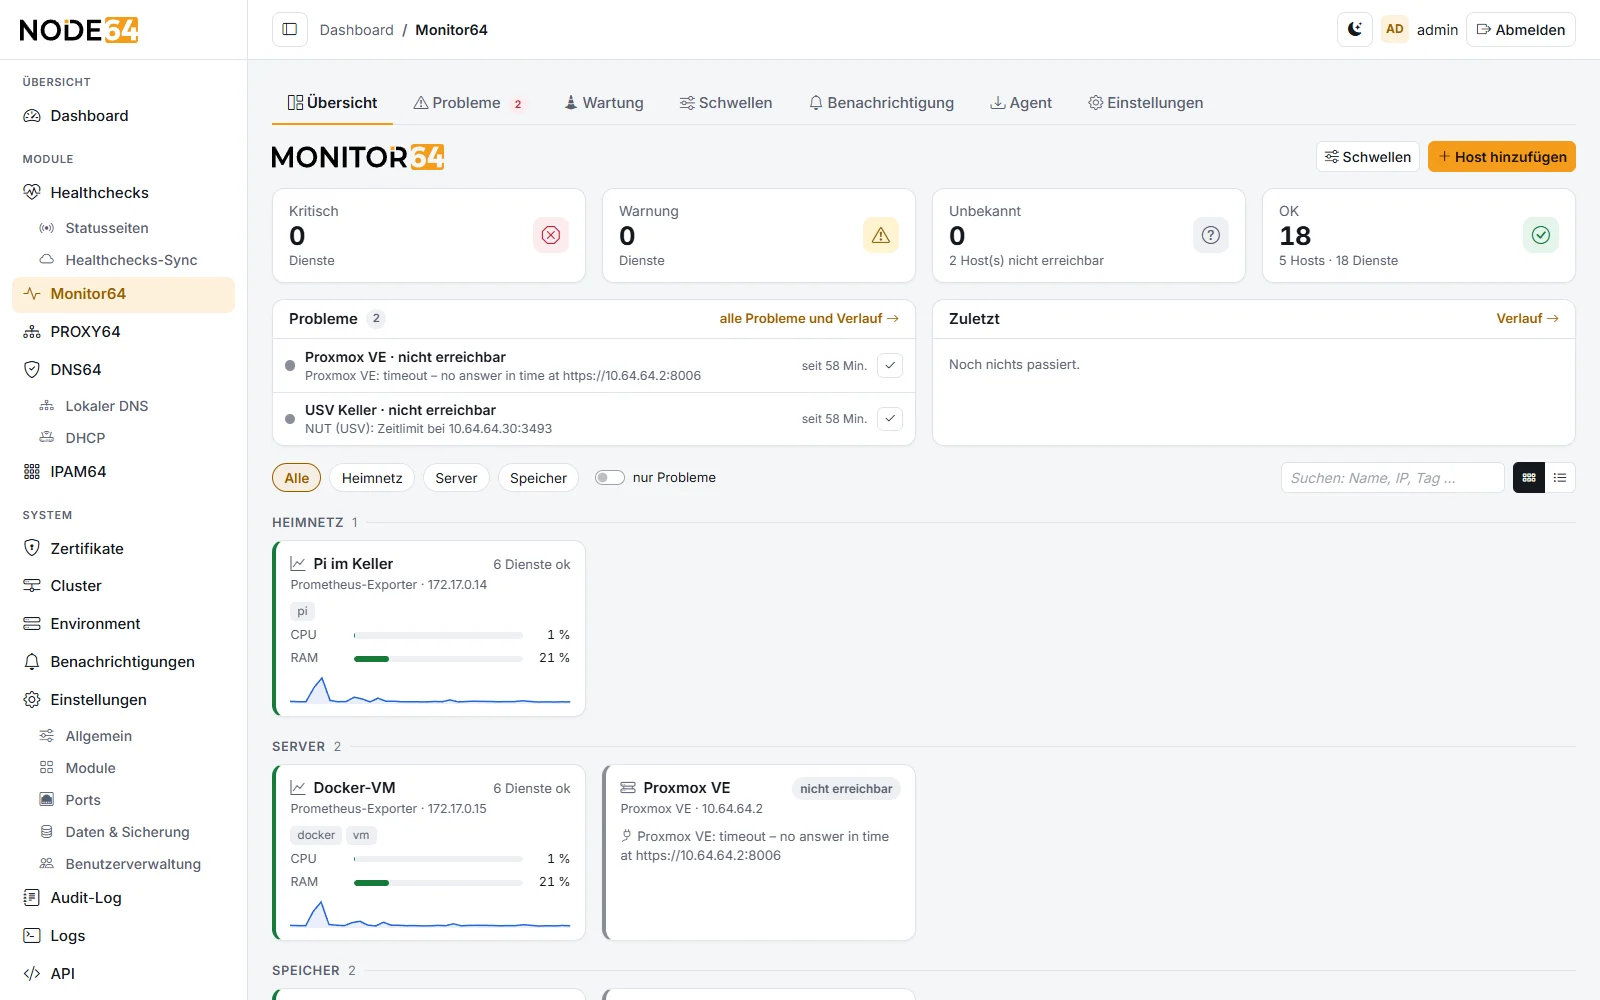
Monitor64 überwacht deine Server, NAS, Hypervisor, Container, Mail-Server, Switches, USV und Drucker mit Messwerten, Schwellen und Verlauf: CPU, RAM, Dateisysteme, Platten samt SMART, Netzwerk-Ports, Temperaturen, Updates und Dienste. Wird es eng, kommt eine Meldung – bevor etwas ausfällt. Gedacht für Homelab bis Mittelstand, bewusst leichter als CheckMK oder Zabbix.
 ┌─────────────────────────────────────────┐
 │ Node64 · Monitor64                      │
 │ Schwellen · Probleme · Verlauf · Wartung│
 └──┬──────────┬───────────┬───────────┬───┘
    │ Agent    │ SSH       │ API       │ SNMP
    ▼          ▼           ▼           ▼
 ┌───────┐ ┌────────┐ ┌──────────┐ ┌─────────┐
 │Linux  │ │Synology│ │Proxmox VE│ │Switch   │
 │Windows│ │Unraid  │ │PBS·Docker│ │Router   │
 │FreeBSD│ │Appl.   │ │TrueNAS   │ │USV·NAS  │
 └───────┘ └────────┘ │iDRAC·iLO │ │Drucker  │
                      └──────────┘ └─────────┘
Zwei Fragen, zwei Module
Healthchecks beantworten „läuft es?“ – erreichbar oder nicht, lokal und von außen über ipv64.net. Monitor64 beantwortet „wie geht es dem System?“ – mit Messwerten, Schwellen und Verlauf. Beide arbeiten unabhängig und ergänzen sich: Die Webseite prüft der Healthcheck, die Platte darunter Monitor64.
- Vorher melden statt nachher: „Dateisystem in 2 Tagen voll“, „SSD zu 90 % verschlissen“, „USV nur noch 10 Minuten“.
- Eine Meldung, nicht hundert: Antwortet ein Host nicht mehr, kommt genau eine Meldung „nicht erreichbar“ – nicht eine je Dienst.
- Gemeinsam auf der Statusseite: Checks unter „Dienste“, Systeme aus Monitor64 unter „Systeme“.
Was Monitor64 überwacht
Ein Host ist ein überwachtes System, ein Zugang der Weg zu seinen Werten. Mehrere Zugänge je Host sind möglich – etwa die Proxmox-API und zusätzlich der Agent für Bonding und Temperaturen.
Monitor64-Agent
Ein Programm ohne Abhängigkeiten für Linux, Windows und FreeBSD/OPNsense – bis hinunter zum Raspberry Pi Zero, mit Stromversorgung und Unterspannung: CPU, Load, RAM, Dateisysteme, Platten-I/O, SMART, Netzwerk je Port, Bonding/LACP, Temperaturen, ZFS/RAID/Btrfs, Inodes, Dienste, Updates, „Neustart nötig“ und eigene Skripte. Hinter NAT verbindet er sich selbst zur Node, Updates kommen signiert und automatisch.
Linux ohne Agent
Wo nichts installiert werden soll – Synology, Unraid, Appliances –, meldet sich die Node per SSH mit eigenem Schlüssel an und liest dieselben Werte wie der Agent.
Proxmox VE & Backup Server
Node, VMs und Container, Speicher, ZFS, Platten samt SMART, Cluster, HA, Ceph und Updates. Beim PBS: Datastores, Alter der Backups je Gruppe, Verify-, GC-, Prune- und Sync-Jobs. Ein Klick macht aus einem Gast einen eigenen Host.
Docker & Podman
Container mit Zustand, Healthcheck, CPU, RAM und Neustarts – über den lokalen Socket, TCP oder SSH. Podman über seine Docker-kompatible API.
NAS & Server-BMC
TrueNAS und Unraid über ihre API: Pools, Platten, Temperaturen, Aufgaben, Apps und VMs. iDRAC, iLO und andere per Redfish: Netzteile, Lüfter, Temperaturen, Laufwerke. USV über NUT: Batterie, Last, Restlaufzeit.
Netzwerk: SNMP, MikroTik, UniFi & FRITZ!Box
Switches, Router, NAS, USV und Drucker mit v1, v2c und v3. Geräteprofile für Synology, QNAP, TrueNAS, MikroTik, UniFi, APC und mehr; Ports mit Auslastung, Fehlern, Link weg und Halbduplex. Bekannte Traps lösen sofort eine Abfrage aus. MikroTik ab RouterOS 7 über die REST-API, UniFi über die Network Application mit Ports und PoE, die FRITZ!Box über TR-064 mit DSL-Werten.
Proxmox Mail Gateway & mailcow
Mail-Warteschlange mit Schwelle und den größten Ziel-Domains, Quarantäne, Dienste bzw. Container – beim Mail Gateway dazu Durchsatz, ClamAV-Signaturen, Cluster und Updates.
Prometheus-Exporter
Wer schon node_exporter oder windows_exporter betreibt, nutzt sie direkt – abgebildet auf dieselben Dienste wie beim Agent, dazu eigene Metriken mit Schwelle.
Erkennen, nicht aufdrängen
Der Assistent zeigt, was auf dem Host zu tun ist, testet die Verbindung und listet die gefundenen Dienste. Übernommen wird nur, was du auswählst – neue Dienste kommen als Hinweis, nie automatisch.
Sinnvolle Standards, fein anpassbar
Meist reicht der Standard. Abweichungen legst du je Gruppe, Tag oder direkt am Host fest – die genaueste Stufe gewinnt, jedes Feld erbt einzeln.
- Dauer und Hysterese: Eine Schwelle zählt erst, wenn alle Messungen im Zeitraum darüber liegen; Werte an der Grenze springen nicht hin und her.
- Trend: Meldung, wenn ein Dateisystem in 7 bzw. 2 Tagen voll ist.
- Feste Regeln: SMART FAILED, RAID/ZFS degraded, Bond-Mitglied weg, Sicherheitsupdates, Gast läuft nicht, Backup zu alt und mehr.
| Messgröße | Warnung | Kritisch |
|---|---|---|
| CPU-Auslastung (15 Min.) | 90 % | 95 % |
| RAM belegt (5 Min.) | 80 % | 90 % |
| Dateisystem, Pool, Datastore | 80 % | 90 % |
| Plattentemperatur HDD/SSD · NVMe | 50 °C · 70 °C | 60 °C · 80 °C |
| SSD-Verschleiß | 80 % | 90 % |
| Port-Auslastung (5 Min.) | 80 % | 90 % |
| Toner/Tinte unter | 15 % | 5 % |
| USV-Restlaufzeit auf Batterie unter | – | 10 Min. |
Mehr als Graphen
Monitor64 bringt mit, was aus Messwerten Betrieb macht – und nutzt dafür, was Node64 ohnehin kann.
Probleme mit Ablauf
Wann geöffnet, wohin gemeldet, wer quittiert oder gelöst hat – auch als CSV. Quittieren stoppt Erinnerungen, bis es schlimmer wird.
Wartungsfenster
Für Hosts, Gruppen oder Tags: jetzt, geplant oder wiederkehrend. Aufgezeichnet wird weiter, gemeldet erst danach – falls dann noch etwas gestört ist.
Die Kanäle der Node
Telegram, Discord, ntfy, Mail und alle anderen Kanäle von Node64 – je Stufe wählbar, mit Erinnerungen, Ruhezeit und Ruhe bei flatternden Diensten.
Statusseiten
Hosts und einzelne Dienste erscheinen auf den Statusseiten der Healthchecks im Abschnitt „Systeme“ – nach außen nur Bezeichnung und Zustand, keine Werte oder Adressen.
Cluster mit Ersatz-Node
Im Node64-Cluster überwacht je Host genau eine Node. Fällt sie aus, übernimmt nach etwa 2 Minuten eine Ersatz-Node – ohne Doppelmeldungen.
Sicher gebaut
Der Agent kennt nur feste Abfragen, keine Shell. Node und Host weisen sich mit Schlüsseln aus, Zugangsdaten gehen erst an bestätigte Fingerabdrücke und liegen verschlüsselt.
Prometheus & API
Zustände und Werte als Metriken für Grafana, alle Funktionen per JSON-API mit OpenAPI-Beschreibung.
Export & Backup
Monitor64 steckt vollständig im Konfig-Export und im Backup der Node; der Verlauf liegt in einer eigenen Datei im Datenverzeichnis.
Monitor64 und typische Alternativen
Große Monitoring-Systeme können sehr viel, brauchen aber einen eigenen Server und Einarbeitung. Monitor64 deckt das ab, was Homelab und kleine Firmen wirklich brauchen – im Container, der ohnehin läuft.
| Funktion | Monitor64 | Klassisches Monitoring (z. B. CheckMK, Zabbix) | Uptime-Monitor (z. B. Uptime Kuma) |
|---|---|---|---|
| Messwerte mit Schwellen und Verlauf | nur erreichbar / nicht erreichbar | ||
| Agent für Linux, Windows, FreeBSD | signiert, Auto-Update | – | |
| Proxmox VE/PBS, Docker, TrueNAS, Unraid, mailcow ab Werk | Assistent | teils über Plugins oder Vorlagen | teils (Erreichbarkeit) |
| SNMP mit Geräteprofilen und Traps | – | ||
| Eigener Server und Datenbank nötig | nein, im Node64-Container | meist ja | nein |
| Einarbeitung | Minuten, Standards ab Werk | Tage | Minuten |
| Prüfung von außen und öffentliche Statusseite | mit Healthchecks + ipv64.net | Zusatz nötig | |
| Weitere Module im selben Container | Healthchecks, PROXY64, DNS64, DynDNS64, Honeypot64 | – | – |
Angaben zu den Alternativen nach allgemeinem Kenntnisstand für eine typische Installation; Funktionen können sich mit neuen Versionen ändern.
Häufige Fragen
Alles Weitere steht Schritt für Schritt in der Monitor64-Doku. Fragen und Wünsche gern ins Forum v64.tech.
Wissen, wie es deinen Systemen geht
Node64 installieren, Monitor64 unter Einstellungen → Module einschalten, ersten Host hinzufügen. Die ersten Werte kommen sofort.
Passend dazu: Healthchecks prüfen Webseiten und Dienste lokal und von außen, die Zertifikatsverwaltung versorgt Proxmox und NAS mit Let's Encrypt.